AI AGENT / EVALUATION
AI 面试助手
把 JD、简历、面试追问和评估报告连接成一条可追溯的候选人分析流程。
01 / THE CONTEXT
问题从哪里来
通用模型可以很快给出候选人匹配结论,但容易把岗位要求误当作候选人的经历,也可能在重复提问时改变评分。招聘判断需要看到依据,而不仅是一个分数。
让模型输出与文档证据、评分规则和面试对话保持关联,使招聘者能够复核“为什么这样判断”。
做出一个从文档分析到模拟面试、再到报告生成的 MVP,并为评分质量保留离线检查机制。
02 / THE PROCESS
从判断到方案
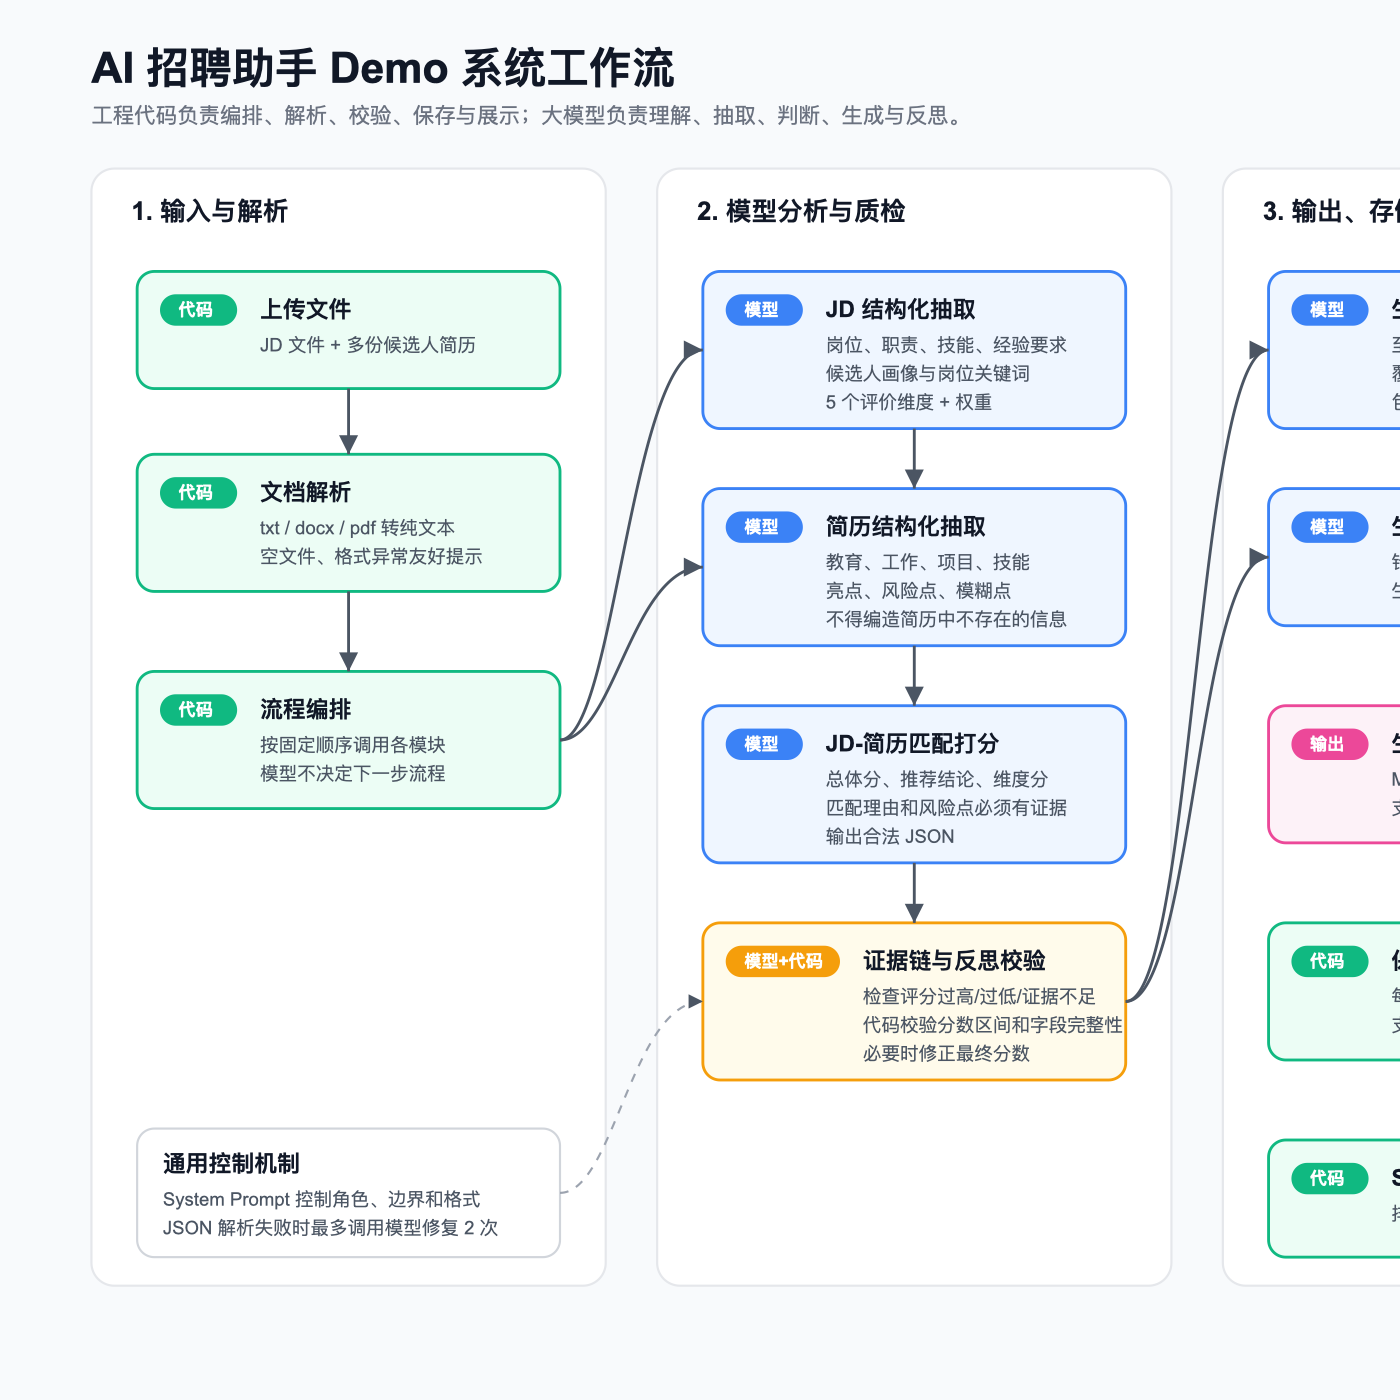
工作流从结构化岗位要求和简历开始,先做证据化匹配,再生成面试题与动态追问。评分结果经过规则复算和反思校验,最后汇总到报告。
解析岗位和简历
支持 TXT、DOCX、PDF 输入;抽取岗位要求和候选人经历,让后续问题有明确来源。
按 Rubric 匹配
用五维评分 Rubric、权重和分数锚点组织判断;确定性加权复算用来检查模型总分是否与维度分一致。
根据风险动态追问
结合匹配理由、简历模糊点和当前回答生成下一轮问题,并对单轮回答形成结构化评价。
生成可回看的报告
保存候选人分析与面试记录,汇总证据、风险和对话评价,供招聘者复核。
关键设计取舍
要求证据链
维度分和匹配理由应能追溯到 JD 或简历内容,减少模型凭关键词或印象下结论。
把数值与语言分开检查
总分由权重复算,定性判断再交给反思校验;两者分别暴露不同类型的错误。
用样本校准而非自证
仓库提供人工标注样本、一致性与对照测试脚本,供持续检查排序与重复评分稳定性。
03 / THE WORK
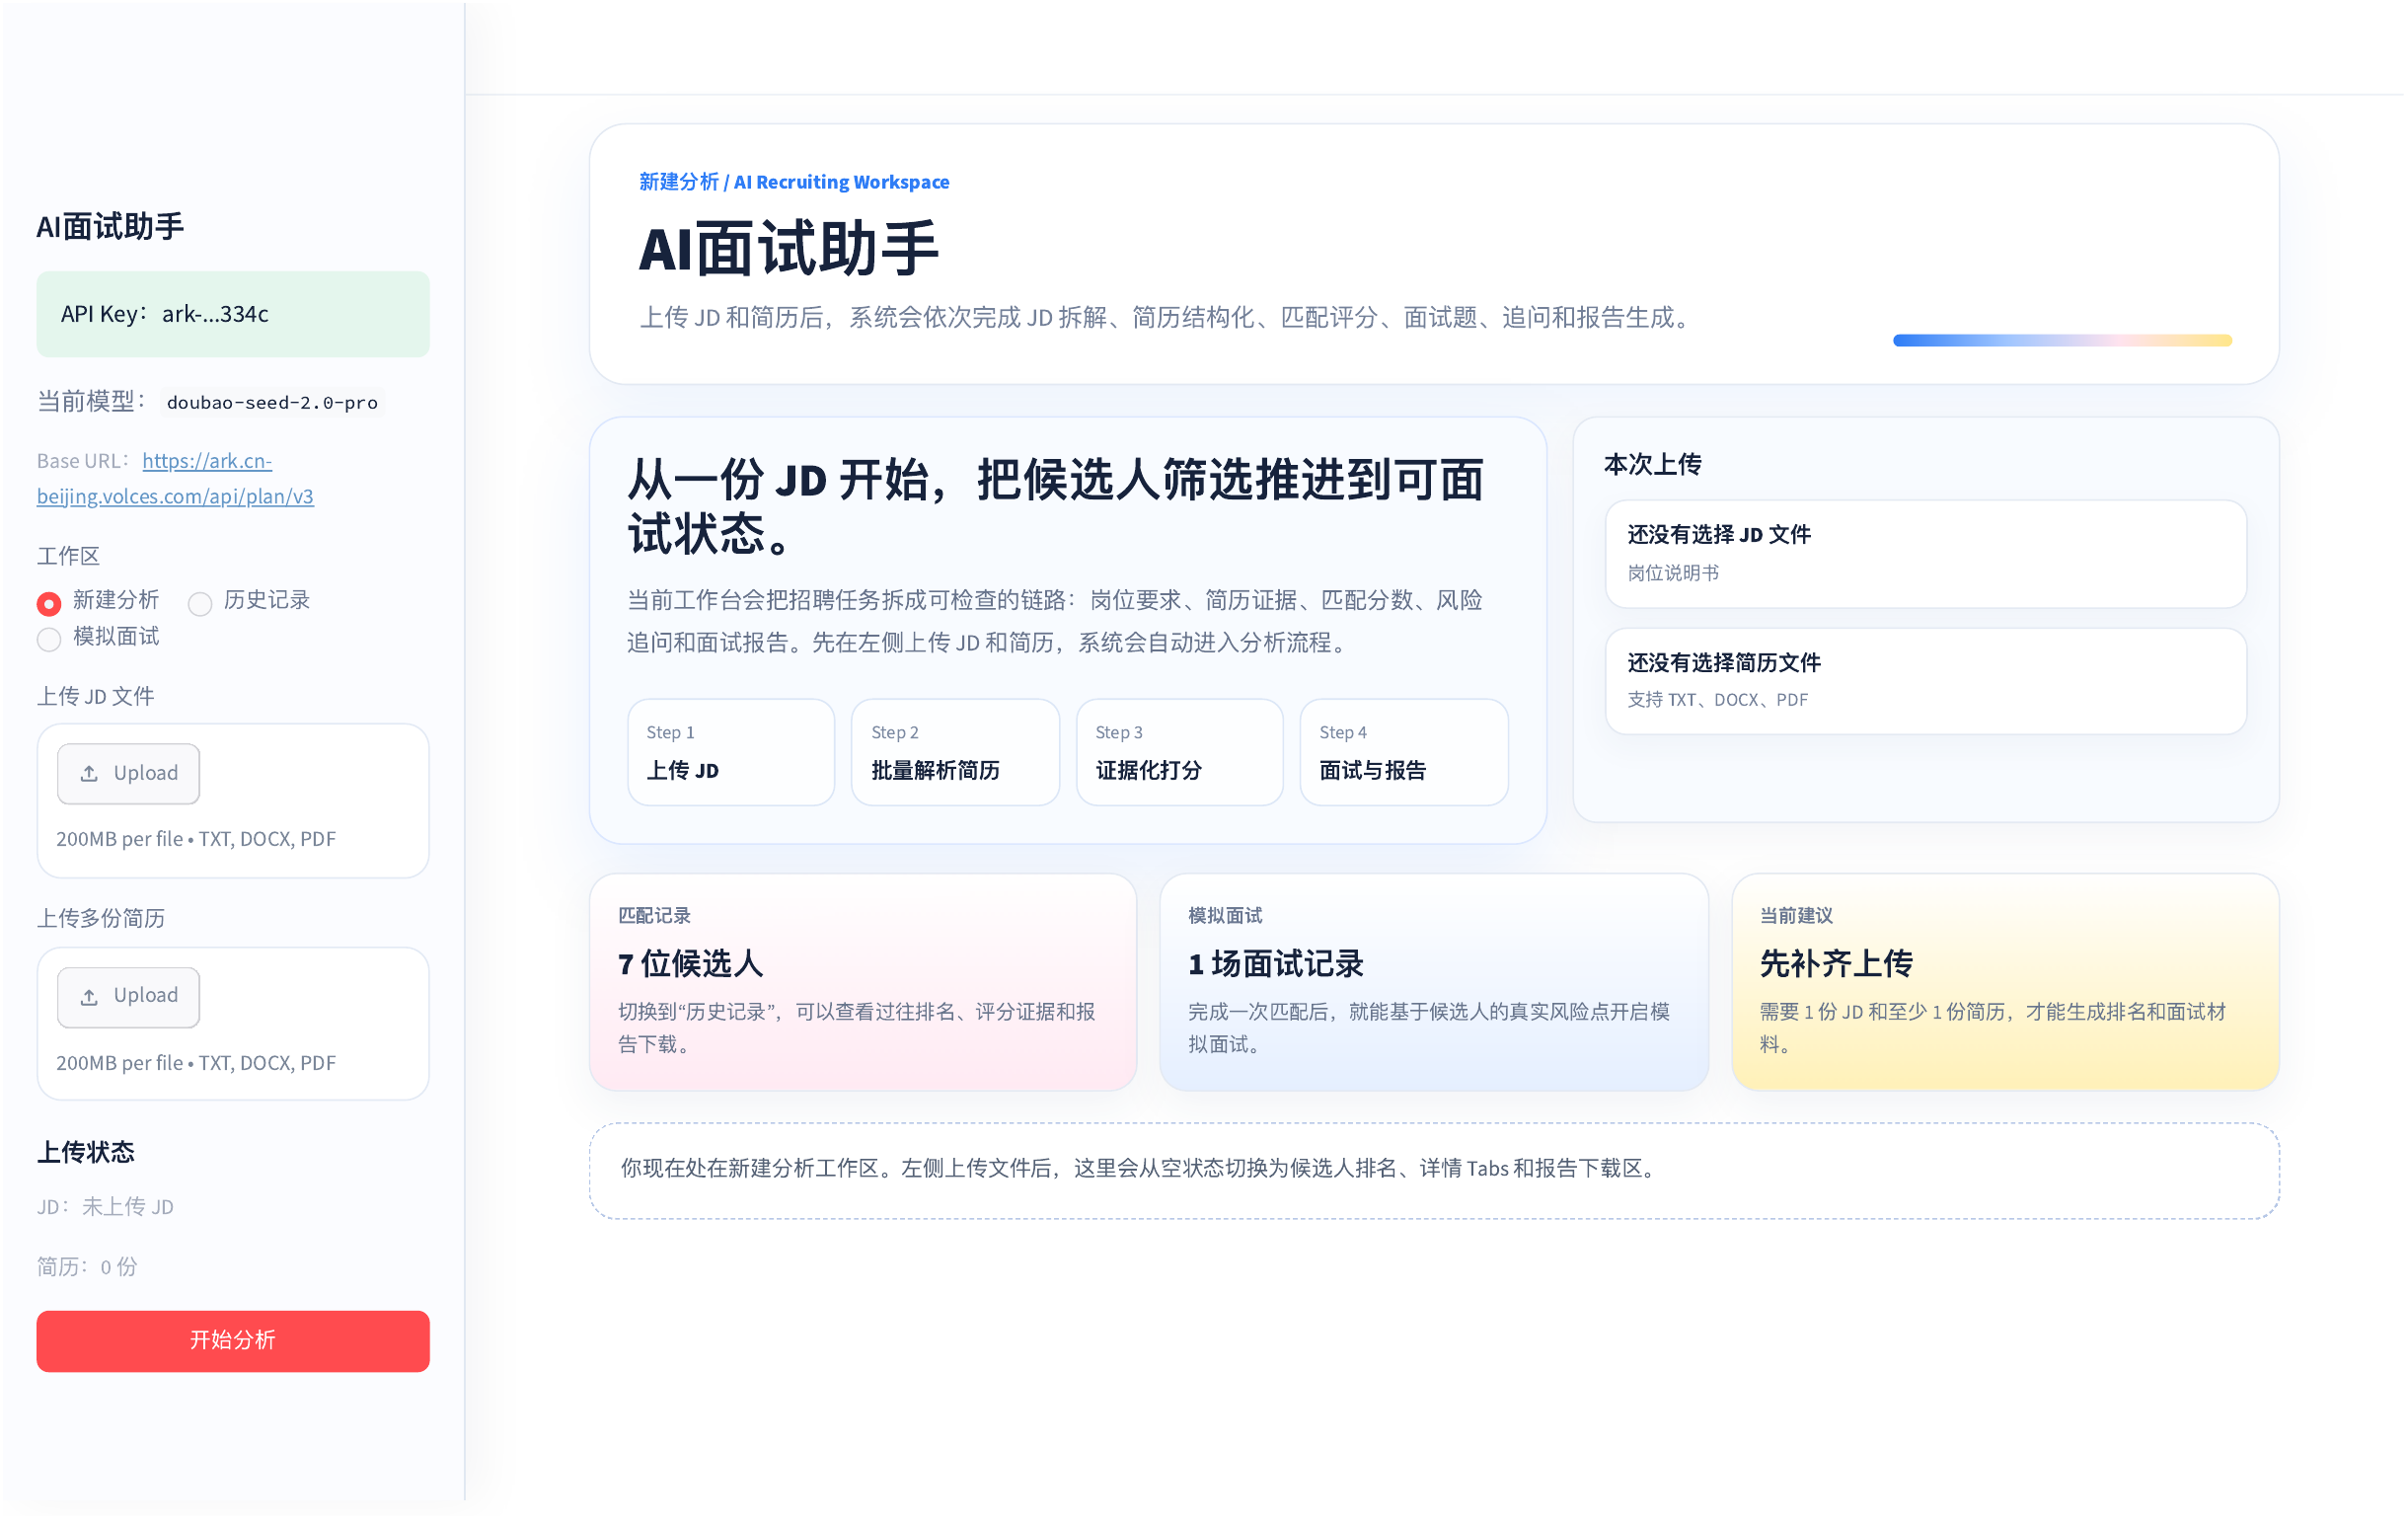
界面与产出
04 / THE OUTCOME
做到了什么,仍需验证什么
完成了基于 Python、Streamlit 和大模型接口的 MVP,包括文档解析、匹配、模拟面试、回答评价及报告保存。评分质量工具已进入代码库;目前没有可公开核验的招聘成效或稳定性数值。
- 仓库包含五维 Rubric、加权复算、证据检查与反思校验模块。
- 提供人工标注样本与离线质量检查脚本。
- 产品定位是辅助判断,报告需要招聘者复核。
下一步应扩大人工标注样本,分别观察证据引用是否准确、追问是否有信息增量、评分排序是否稳定,再决定哪些判断适合自动化。